진승우 프로필 진승우 백엔드 개발자 이력서 PDF
Project

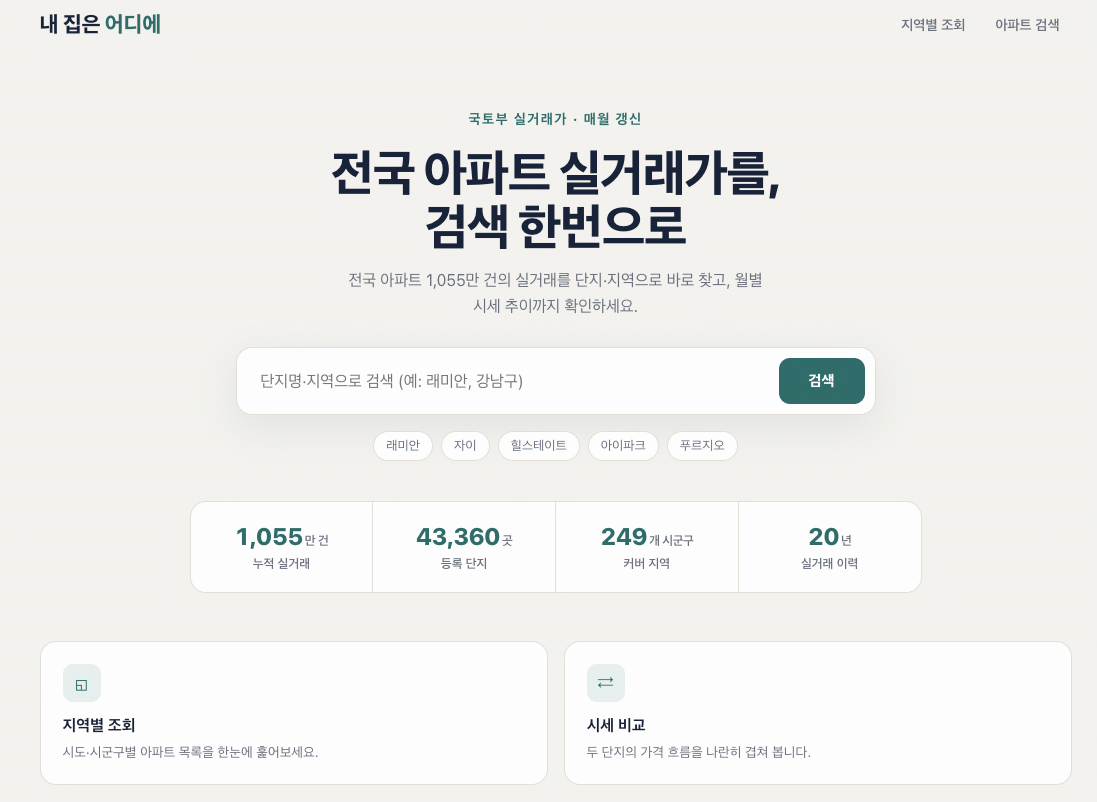
내 집은 어디에

전국 아파트 실거래가 1,055만 건을 수집·최적화해 단지·지역으로 조회하는 서비스입니다.
부하 테스트로 병목을 실측한 뒤 인덱스·캐시·Materialized View로 개선하였습니다.

내 집은 어디에 썸네일
기간 2026. 6 ~ 2026. 7 | 인원 1명 (개인)
핵심 구현
01Trigram 인덱스로 단지명 부분검색 최적화
→ DB 84.2% · 응답 53.7% 개선
02Materialized View로 월별 시세 집계 최적화
→ 88.9% 개선 (집계 쿼리)
03Redis 대신 Caffeine 로컬 캐시 선택
→ 76% 개선 (응답시간)
사용 기술
Java 21 Spring Boot Spring Batch React PostgreSQL Caffeine(로컬캐시) Railway Docker k6
프로젝트 링크 GitHub
TroubleShooting

트러블 슈팅

문제를 발견했을 때 증상만 막는 대신, 원인이 된 구조를 추적하고 운영 중 다시 터지지 않도록 설계까지 바꾼 사례를 담았습니다.

데이터 수집 중 실패 한 건이 전체 재수집을 유발하던 문제

Spring Batch Chunk 기반으로 트랜잭션을 분리하고 재시작 가능한 구조를 적용해, Tasklet 단일 트랜잭션에서 중간 실패 시 전체를 처음부터 재수집해야 했던 문제를 해결했습니다.

벨로그포스팅 보기
문제 요약

국토부 API로 전국 250개 시군구 데이터를 수집하는 배치가 전체를 단일 트랜잭션으로 처리하고 있었다. 수집 중 API 타임아웃이나 순간 장애 하나가 발생하면 그 시점까지의 작업이 전부 롤백되고, 처음부터 다시 데이터를 수집해야 했다.

Before Tasklet 단일 트랜잭션으로 전체 수집

250개 시군구 수집이 하나의 트랜잭션 단위

중간 실패 시 처리 여부와 무관하게 전체 재실행 필요

중복 수집 방지 로직 없음

After Chunk + Skip/Retry + 재시작 가능한 구조

500건 단위 Chunk로 트랜잭션 분리, 중복 데이터는 skip 후 진행

PipelineLog에 완료된 시군구를 기록해, 재실행 시 이미 처리된 시군구는 건너뛰고 실패 지점부터 재개

ON CONFLICT DO NOTHING으로 중복 INSERT 방지(멱등성 확보)

핵심 정리

대량 외부 API 연동 배치는 "전부 성공 아니면 전부 실패"가 아니라, 실패 단위를 최소화하고 실행 이력을 남겨 재시작 가능하게 설계해야 한다. 멱등성까지 갖추면 재시도해도 데이터가 꼬이지 않는다.

API 대량 호출의 복합 문제 해결 — 봇 차단, 버퍼 초과, 속도 제한

국토부 실거래가 API를 대량 호출하는 과정에서 연달아 발생한 요청 차단·응답 처리·속도 제한 문제를, WebClient 설정과 RateLimiter 도입으로 해결했습니다.

문제 요약

전국 시군구를 순회하며 국토부 API를 호출하는 초기 구현에서 세 가지 문제가 연달아 발생했다. WebClient 기본 설정으로 요청 시 일부가 차단되었고(User-Agent 미지정), 한 번에 수천 건이 오는 대량 응답이 기본 메모리 버퍼(256KB)를 초과해 예외가 발생했으며, 호출 속도가 빨라 국토부 서버로부터 429 Too Many Requests 응답을 받았다.

Before WebClient 기본 설정, 무제한 연속 호출

User-Agent 미지정 → 일부 요청이 봇으로 간주되어 차단

기본 버퍼 256KB → 대량 응답 시 DataBufferLimitException 발생

속도 제어 없이 연속 호출 → 429 Too Many Requests 반복 발생

After WebClient 커스터마이징 + RateLimiter 도입

defaultHeader로 User-Agent 지정해 브라우저 요청처럼 처리

maxInMemorySize를 10MB로 상향해 대량 XML 응답 처리

Resilience4j RateLimiter로 초당 5건 제한, 초과 호출은 자동 대기

핵심 정리

공공 API는 문서화되지 않은 방어 로직(봇 차단, 속도 제한)이 있는 경우가 많아, 실제로 호출해보며 원인을 하나씩 역추적해야 한다. 프레임워크 기본값(버퍼 크기 등)도 항상 우리 데이터 규모에 맞는 건 아니다.